2D感知
摘要:本文从自动驾驶的相机图像出发,区分目标检测、目标跟踪与三类分割任务,再梳理对应算法和处理流程。最后将相机三维感知、激光雷达和毫米波雷达作为扩展,建立感知任务之间的联系。
1. 感知在解决什么问题
自动驾驶感知需要回答:周围有什么、在哪里、是否正在运动。传感器提供原始数据,算法将数据转换为目标、道路区域或运动状态等信息,供后续预测与规划使用。
以一张包含两辆汽车、一个行人和道路的图像为例:
- 目标检测:找出汽车和行人,用框标记位置。
- 语义分割:判断每个像素属于汽车、行人、道路还是其他类别。
- 实例分割:描出每个目标的轮廓,并区分第一辆车和第二辆车。
- 全景分割:既标注道路等区域,也区分每个汽车、行人实例。
- 目标跟踪:在连续帧中判断“这一帧的车”和“上一帧的车”是不是同一个目标。
这些任务的输出不同,不能将它们看作同一算法的不同名称。
1.1 2D 与 3D:看输出,不只看传感器
2D 感知主要在图像平面中描述目标,位置通常用像素坐标表示。检测框告诉我们目标在图像中的范围,但仅靠这个框还不知道它距离车辆多少米。
3D 感知进一步估计空间位置、尺寸、朝向或深度。因此,相机既能用于 2D 感知,也能通过几何关系和学习方法用于 3D 感知。
| 输入 | 常见任务 | 本文中的位置 |
|---|---|---|
| 单目、双目或多目图像 | 2D 检测、分割、跟踪,也可估计深度和三维目标 | 重点介绍图像平面任务 |
| 激光雷达点云 | 三维检测、点云分割、聚类与配准 | 第 6 节扩展 |
| 毫米波雷达数据 | 距离、径向速度等测量,以及目标检测与跟踪 | 第 6 节扩展 |
2. 目标检测:有什么,在哪里
目标检测通常输出目标类别、置信度与二维边界框。一个检测结果可以写为:
是类别, 是置信度,后四项描述检测框。不同实现也可能使用中心坐标与宽高,需要核对坐标格式与是否归一化。
2.1 常见算法的思路
| 算法系列 | 核心思路 | 理解重点 |
|---|---|---|
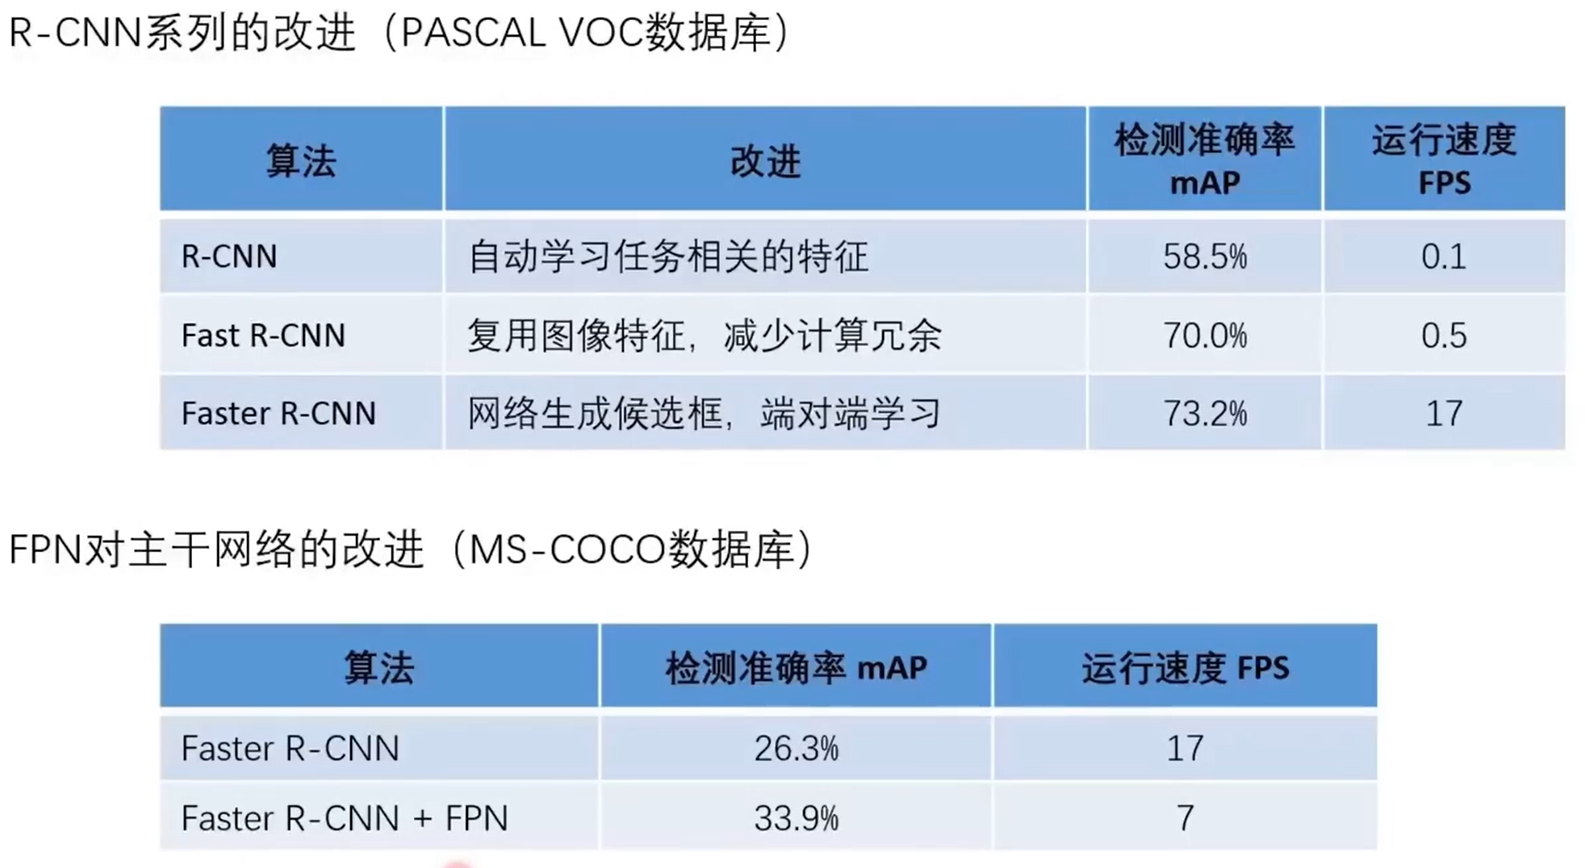
| R-CNN 系列 | 以 Faster R-CNN 为例,先生成候选区域,再分类和细化位置 | 候选区域与两阶段检测 |
| YOLO 系列 | 在单阶段框架中预测类别与位置,具体设计随版本变化 | 特征提取、预测头与速度精度权衡 |
| CenterNet | 本文指将目标表示为中心点的方法,预测中心热力图、尺寸和偏移 | 如何由中心点恢复检测框 |
阅读算法时应追问:输入如何变成特征、网络预测什么、怎样将预测解码为框。只记住名称,难以理解它们的区别。
2.2 用车辆和行人检测理解输出
假设 CenterNet 找到一个“汽车”中心点,还需要预测宽高,才能恢复完整检测框。降低置信度阈值可能保留更多目标,也会增加误检;提高阈值则可能漏掉远处或被遮挡的目标。
原笔记中的“基于 CenterNet 的车辆和行人检测”可作为实践方向:读取图像 → 模型推理 → 解码 → 映射回原图 → 绘制结果。这里列出的是学习任务,不代表已经完成模型训练或部署。
3. 图像分割:每个像素属于什么
检测框只描述矩形范围,框内可能同时包含目标和背景。分割进一步确定像素级区域,关键是分清“类别”和“实例”。
3.1 语义分割:区分类别
语义分割为每个像素分配类别,例如道路、人行道、汽车。同类别目标使用相同类别标签,不负责区分两辆汽车的身份。
常见方法包括 FCN、U-Net、DeepLab。理解时重点关注:下采样如何提取语义,上采样如何恢复分辨率,以及如何保留目标边界。
3.2 实例分割:区分同类中的不同目标
实例分割既判断类别,也为每个独立目标输出掩码。两辆相邻汽车都属于“汽车”类,但分别有自己的像素区域。
Mask R-CNN 是实例分割的代表方法,在检测分支之外预测实例掩码,因此不应只将它列为普通语义分割模型。参考:Mask R-CNN 原论文。
3.3 全景分割:同时描述目标和场景区域
全景分割统一语义与实例分割:既覆盖道路、天空等区域,也区分汽车、行人等可数目标。标准任务定义要求每个像素有语义标签,可数目标还要区分实例。参考:Panoptic Segmentation 原论文。
| 任务 | 区分类别 | 区分同类目标实例 | 两辆汽车的输出 |
|---|---|---|---|
| 语义分割 | 是 | 否 | 都标为汽车 |
| 实例分割 | 是 | 是 | 各自有独立掩码 |
| 全景分割 | 是,覆盖场景区域 | 对可数目标区分 | 独立汽车实例与道路等区域共同组成场景 |
4. 目标跟踪:连续帧中是不是同一个目标
检测主要回答单帧的位置,跟踪将多帧结果关联,为同一目标维持连续的 ID。遮挡、目标交叉与漏检都可能造成 ID 切换。
| 方法 | 主要思路 | 理解重点 |
|---|---|---|
| DeepSORT | 结合运动预测与外观特征进行数据关联 | 预测、匹配、轨迹更新与删除 |
| CenterTrack | 利用相邻帧信息,预测目标中心及其跨帧位移 | 如何通过位移关联目标 |
典型的基于检测的跟踪流程是:检测当前帧 → 预测已有轨迹位置 → 匹配检测与轨迹 → 更新状态。跟踪 ID 是系统维护的轨迹身份,不等于现实中永远不变的身份标识。
图像中的位移也不等于真实空间运动。目标框向右移动,可能来自目标运动,也可能来自自车转弯。若要估计米制速度,还需引入深度、标定与自车运动等信息。
5. 串起来看:一个 2D 感知流程
以车辆、行人检测与跟踪为例:
- 输入图像:读取相机帧及时间信息。
- 预处理:缩放、归一化,必要时校正畸变;记录尺寸和坐标变换。
- 模型推理:提取特征,预测类别与位置。
- 后处理:解码、置信度筛选,并按模型需要处理重复预测。
- 坐标恢复:将结果映射回原始图像。
- 跨帧关联:维护目标 ID 与轨迹状态。
- 结果检查:观察误检、漏检、ID 切换和处理延迟。
语义分割在推理与后处理中输出像素类别图,实例分割则还输出实例掩码。检测、分割与跟踪可以组合,但不要求每条感知链路都运行所有任务。
评价应与任务对应:检测关注框与类别,分割关注像素区域,跟踪还关注跨帧身份的一致性。单张效果图不能说明模型在夜间、遮挡或远距离下同样可靠。
6. 从 2D 感知扩展到其他方向
下面保留原笔记中的其他方向,作为知识地图。它们与图像任务有关联,但应分别学习输入表示、输出和评价方式。
6.1 相机三维感知
主要任务包括三维目标检测与深度估计。单目结合图像线索、几何或学习先验估计空间信息;双目利用左右图像对应关系估计视差,多目则利用更多视角。
校正后的理想双目模型中:
是以像素为单位的焦距, 是基线长度, 是像素视差。若 以米计,深度 也以米计。视差较小时,深度对视差误差更敏感。原笔记中的 PSMNet 可作为双目视差估计案例,再结合标定参数换算深度。
6.2 激光雷达感知
激光雷达提供点云,可以直接处理点,也可以转换为体素、鸟瞰图(BEV)或距离图(Range Image)。这些是数据表示方式,不应与检测、分割等任务混为一谈。
| 方向 | 算法示例 | 学习重点 |
|---|---|---|
| 点特征与三维检测 | PointNet++、PointRCNN、3DSSD | 无序点集的特征提取与检测 |
| 体素或柱状编码与检测 | VoxelNet、SECOND、PointPillars | 将点云编码为便于网络处理的结构 |
| BEV 检测 | PIXOR、AFDet | 在俯视空间预测目标相关信息 |
| 距离图处理 | LaserNet、RangeNet++ | 利用扫描角度组织数据;二者对应任务不同 |
| 多表示或多传感器融合 | PV-CNN、MV3D | 区分点与体素融合、图像与点云融合 |
PointPillars 按柱状区域编码点云并形成俯视特征,不宜仅因为存在多个处理阶段就归为多传感器融合。参考:PointPillars 原论文。
点云分割也有语义、实例与全景之分:RangeNet++、SqueezeSeg、RandLA-Net 可用于学习语义分割;SGPN 用于学习实例分割;Panoptic-PolarNet 用于学习全景分割。原笔记的实践方向可保留为 PointPillars 三维检测和 RandLA-Net 语义分割。
学习网络前,也可以先了解几何处理:点云过滤、地面分割、点云聚类与点云配准。
6.3 毫米波雷达感知
毫米波雷达可提供距离、径向速度等信息,具体输出取决于硬件与处理链路。首先应区分原始信号、距离—多普勒等中间表示,以及处理后的检测点或目标列表。
可以按下面的顺序学习:
- 理解 FMCW 雷达的测量原理。
- 学习如何从信号中提取距离、速度与角度信息。
- 对检测点聚类,再用卡尔曼滤波等方法维护轨迹。
- 进一步学习基于雷达点云或底层信号表示的深度学习方法。
原笔记中的 FMCW 信号模拟、运动目标分析和底层数据可视化,可分别安排在这些阶段。基于点云与基于底层数据的方法,区别在输入层级,不是独立于雷达感知的另一种任务。
7. 阅读与实践顺序
先用同一个场景分清检测、跟踪与三类分割的输出,再选择一种检测方法跑通图像输入、推理与显示。随后加入连续帧跟踪,观察遮挡和漏检对轨迹的影响;理解图像平面任务后,再扩展到深度估计与三维感知。
每学习一个算法,都可以围绕四个问题整理笔记:输入是什么、输出是什么、核心步骤是什么、容易在哪些场景失效。这样更容易把算法名称组织成有联系的知识体系。
本篇文章受 CC BY-NC-SA 4.0 协议保护,转载请注明出处。